Objectif et prérequis
Uniformisez l’écriture des codes produit et conservez le dernier enregistrement de chaque code.
Cet exemple utilise des données et paramètres de démonstration. Validez le résultat attendu dans votre propre environnement avant de connecter des destinations de production. Les identifiants demo_* sont illustratifs : sélectionnez vos propres connexions ou sources pédagogiques dans l’éditeur. Le JSON ci-dessous présente la structure des blocs et connexions, pas une archive de flux prête à transférer.
Données d’entrée pédagogiques
products.csv
SKU;Name
  t01 ;Tea old
T01;Tea new
 c01;Coffee
Blocs, connexions et paramètres exacts
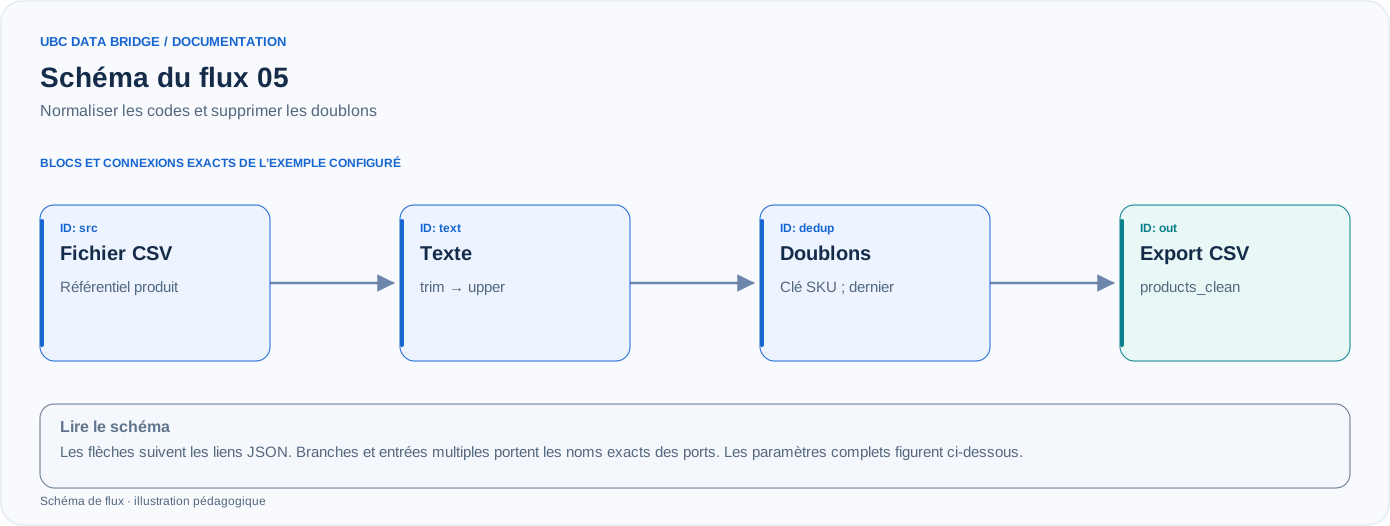
Topologie de l’exemple 05 : 4 blocs, 3 connexions. Les identifiants de nœuds et les ports du graphe configuré sont conservés.
Ajoutez les blocs listés dans le concepteur, ouvrez les propriétés de chacun et définissez ces valeurs. Les noms demo_* désignent les sources et connexions pédagogiques.
| Bloc | Paramètre |
|---|---|
| 1 Fichier src |
|
| 2 Transformation de texte text |
|
| 3 Dédoublonnage dedup |
|
| 4 Exportation de données out |
|
Connexions des ports
- src
out→ textin - text
out→ dedupin - dedup
out→ outin
Configuration complète du graphe en JSON
{
  "version": 3,
  "nodes": [
    {
      "id": "src",
      "type": "file",
      "label": "src",
      "config": {
        "role": "source",
        "source_id": "demo_products",
        "options": {
          "sheet": "CSV",
          "range": "A1:B4",
          "header": true,
          "delimiter": ";"
        }
      }
    },
    {
      "id": "text",
      "type": "text",
      "label": "text",
      "config": {
        "fields": [
          "SKU"
        ],
        "operations": [
          {
            "kind": "trim"
          },
          {
            "kind": "upper"
          }
        ],
        "null": "preserve"
      }
    },
    {
      "id": "dedup",
      "type": "deduplicate",
      "label": "dedup",
      "config": {
        "keys": [
          "SKU"
        ],
        "keep": "last",
        "comparison": "text",
        "case_sensitive": true,
        "trim": false
      }
    },
    {
      "id": "out",
      "type": "export",
      "label": "out",
      "config": {
        "format": "csv",
        "filename": "products_clean",
        "destination": "download",
        "delimiter": ";",
        "timezone": "Europe/Kyiv"
      }
    }
  ],
  "edges": [
    {
      "source": "src",
      "target": "text",
      "source_port": "out",
      "target_port": "in"
    },
    {
      "source": "text",
      "target": "dedup",
      "source_port": "out",
      "target_port": "in"
    },
    {
      "source": "dedup",
      "target": "out",
      "source_port": "out",
      "target_port": "in"
    }
  ]
}
Résultat attendu
| SKU | Nom |
|---|---|
| T01 | Tea new |
| C01 | Coffee |
Deux des 3 lignes d’entrée restent. « Dernière » signifie dernière dans l’ordre actuel des données, pas la plus récente par date.
Exécuter et vérifier
- Chargez products.csv sans retirer manuellement les espaces au préalable.
- Ordre des opérations : trim, puis upper, puis dédoublonnage par SKU.
- Vérifiez que Tea old a été retiré, que Tea new reste et que c01 est devenu C01.
Erreurs courantes
- Dédoublonner avant la normalisation conserverait les deux variantes t01/T01.
- keep=unique retirerait toutes les lignes ayant une clé répétée ; c’est un autre objectif.
- Si l’ordre source est instable, keep=last ne garantit pas l’enregistrement métier le plus récent.