Rôle
Conserve les champs d’identification sélectionnés et convertit chaque autre colonne en une ligne distincte. Le nom de colonne devient la valeur du champ de période, et le contenu de la cellule devient la valeur de la mesure. Utile pour les tableaux dont les mois ou les mesures sont disposés en colonnes.
Entrées et sorties
Une entrée de tableau, in ; out contient id_columns et deux nouvelles colonnes.
Paramètres
| Le paramètre | Réglages et valeurs | Options et limites |
|---|---|---|
id_columns | Champs répétés dans chaque ligne créée ; de 1 à 100. Tous les autres champs sont dépivotés. | Nombre : 1–100 |
period_column | Le nom du champ destiné aux noms des colonnes d’origine ; Period par défaut. | Par défaut : PeriodJusqu’à 100 caractères |
unpivot_value_column | Le nom du champ destiné aux valeurs des cellules ; Value par défaut. | Par défaut : ValueJusqu’à 100 caractères |
Configuration étape par étape
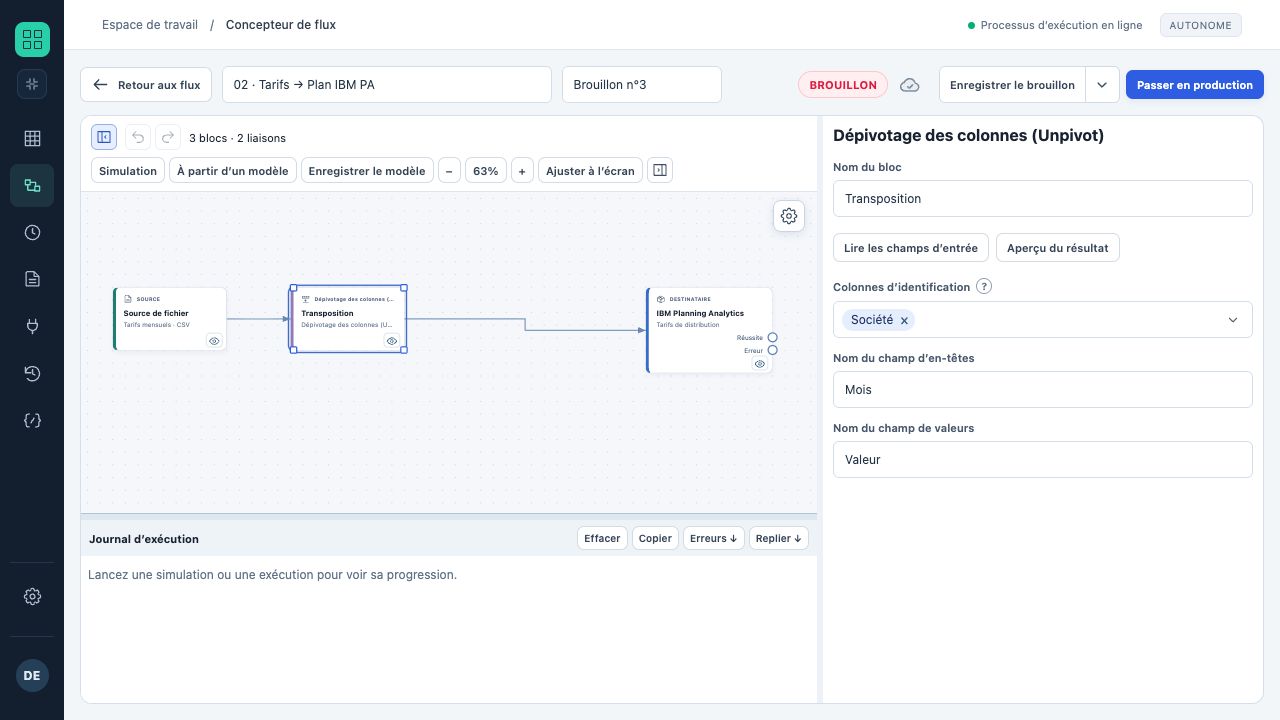
Company reste l’identifiant de ligne, les en-têtes des mois deviennent les valeurs de Month et les valeurs sont placées dans Value.
- Connectez le tableau large et lisez ses champs.
- Sélectionnez tous les champs d’identification, par exemple le produit, le service et le scénario.
- Nommez les nouveaux champs, par exemple Month et Value.
- Vérifiez l’échantillon : chaque mois d’origine doit devenir une ligne distincte.
Règles et diagnostics
- Les noms des champs d’identification et des deux nouveaux champs doivent être différents.
- Ne laissez pas une colonne de texte auxiliaire parmi les périodes : elle serait également dépivotée.
- Le nombre de lignes augmente ; surveillez la limite globale de cellules.
- Après le dépivotage, vous pouvez filtrer séparément les mesures vides et normaliser les nombres.
Exemple de configuration
Entrée : Product=A, Jan=10, Feb=15. id_columns=[Product], period_column=Month, unpivot_value_column=Value. Sortie : A, Jan, 10 et A, Feb, 15.