Завдання та передумови
Привести коди товарів до одного написання й залишити останній запис для кожного коду.
Приклад містить навчальні дані та налаштування. Виберіть власні тестові джерела й підключення замість ідентифікаторів demo_*, відтворіть очікуваний результат і лише потім використовуйте робочі об’єкти.
Навчальні вхідні дані
products.csv
SKU;Name
  t01 ;Tea old
T01;Tea new
 c01;Coffee
Блоки, зв’язки й точні налаштування
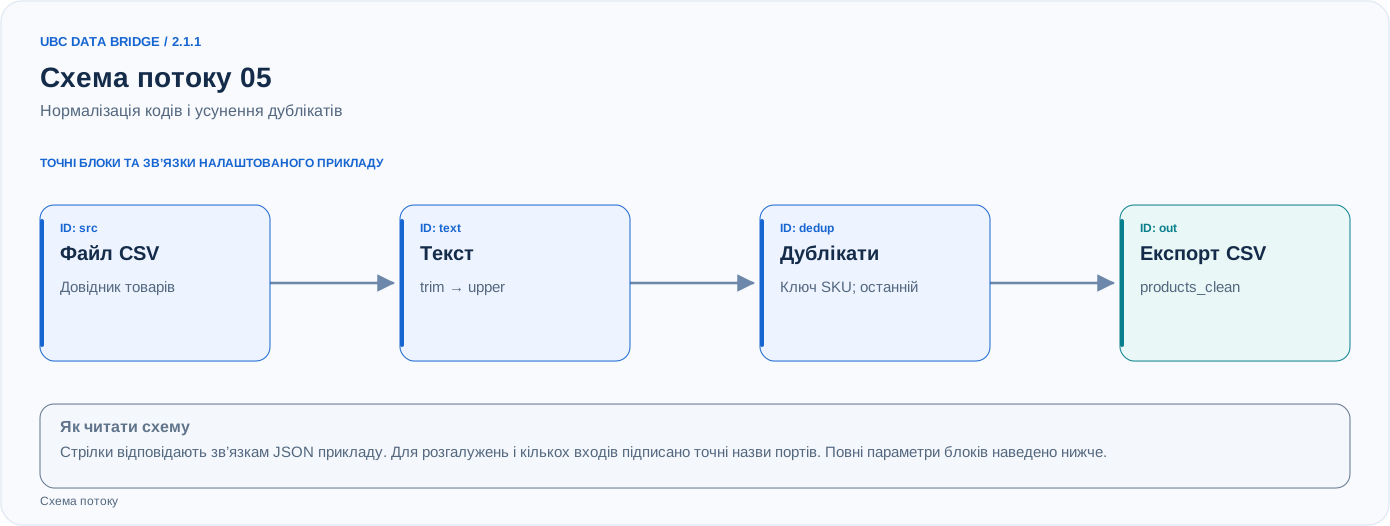
Топологія прикладу 05: 4 блоки, 3 зв’язки. Збережено ідентифікатори вузлів і порти налаштованого графа.
Додайте наведені блоки в конструктор, відкрийте властивості кожного й установіть такі значення. Назви demo_* позначають навчальні джерела та підключення.
| Блок | Налаштування |
|---|---|
| 1 Файл src |
|
| 2 Перетворення тексту text |
|
| 3 Дедублікація dedup |
|
| 4 Вивантаження даних out |
|
Зв’язки портів
- src
out→ textin - text
out→ dedupin - dedup
out→ outin
Повна конфігурація графа JSON
{
  "version": 3,
  "nodes": [
    {
      "id": "src",
      "type": "file",
      "label": "src",
      "config": {
        "role": "source",
        "source_id": "demo_products",
        "options": {
          "sheet": "CSV",
          "range": "A1:B4",
          "header": true,
          "delimiter": ";"
        }
      }
    },
    {
      "id": "text",
      "type": "text",
      "label": "text",
      "config": {
        "fields": [
          "SKU"
        ],
        "operations": [
          {
            "kind": "trim"
          },
          {
            "kind": "upper"
          }
        ],
        "null": "preserve"
      }
    },
    {
      "id": "dedup",
      "type": "deduplicate",
      "label": "dedup",
      "config": {
        "keys": [
          "SKU"
        ],
        "keep": "last",
        "comparison": "text",
        "case_sensitive": true,
        "trim": false
      }
    },
    {
      "id": "out",
      "type": "export",
      "label": "out",
      "config": {
        "format": "csv",
        "filename": "products_clean",
        "destination": "download",
        "delimiter": ";",
        "timezone": "Europe/Kyiv"
      }
    }
  ],
  "edges": [
    {
      "source": "src",
      "target": "text",
      "source_port": "out",
      "target_port": "in"
    },
    {
      "source": "text",
      "target": "dedup",
      "source_port": "out",
      "target_port": "in"
    },
    {
      "source": "dedup",
      "target": "out",
      "source_port": "out",
      "target_port": "in"
    }
  ]
}
Очікуваний результат
| SKU | Name |
|---|---|
| T01 | Tea new |
| C01 | Coffee |
З 3 вхідних рядків лишаються 2. «Останній» означає останній у поточному порядку вхідних даних, а не найпізніший за датою.
Запуск і перевірка
- Завантажте products.csv без попереднього ручного видалення пробілів.
- Порядок операцій: trim, потім upper, потім deduplicate за SKU.
- Перевірте, що Tea old видалено, Tea new залишився, а c01 перетворився на C01.
Типові помилки
- Дедублікація до нормалізації збереже обидва варіанти t01/T01.
- keep=unique видалив би всі рядки повторюваного ключа; це інша задача.
- Якщо порядок джерела нестабільний, keep=last не гарантує вибору найсвіжішого бізнес-запису.